First-party data verdient voorrang: het is nauwkeuriger, privacyvriendelijker en de beste brandstof voor AI-gedreven personalisatie. Third-party data blijft nuttig als schaalvergroter en timingsignaal, maar leunt te veel op verouderde, ongecontroleerde bronnen om leidend te zijn. Dit artikel laat zien hoe je de verschillen herkent, wanneer je welke bron inzet en hoe je stap voor stap een eigen datastrategie bouwt.
First party vs third party data: het volledige overzicht
Vier soorten data bepalen je marketingstrategie, en ze verschillen fundamenteel in eigendom en betrouwbaarheid. First-party data verzamel je zelf, rechtstreeks bij je klant of bezoeker: gedrag op je website, aankopen, CRM-gegevens, e-mailinteracties. Jij bepaalt de kwaliteit, jij hebt toestemming, jij kent de context.
Second-party data is eigenlijk iemand anders’ first-party data, gedeeld via een partnerschap. Denk aan een samenwerking met een softwareleverancier die klantgegevens deelt in ruil voor iets terug. De herkomst is bekend, waardoor de kwaliteit doorgaans hoger blijft dan bij third-party bronnen, zoals ook naar voren komt in de vergelijking van Funnel.
Third-party data koop of huur je van externe partijen: data-brokers, advertentienetwerken, marktonderzoeksbureaus. Niemand in die keten heeft een directe relatie met de persoon achter de data, en dat werkt door in de kwaliteit. Zoals Cdp treffend beschrijft: third-party data is geaggregeerd zonder directe klantrelatie, met lagere nauwkeurigheid en hogere privacyrisico’s als gevolg.
Zero-party data vormt de vierde, vaak onderschatte categorie: informatie die een klant je bewust en actief geeft, zoals voorkeuren in een preferentiecentrum of antwoorden op een onboardingvragenlijst. Combineer je dit met gedragsdata, dan ontstaat een scherper klantbeeld, blijkt uit onderzoek van Forrester.
De verschillen op een rij:
- Eigendom: first- en zero-party is van jou, second-party is gedeeld, third-party is gehuurd.
- Nauwkeurigheid: first-party wint, third-party verliest vaak aan actualiteit en context.
- Schaal: third-party biedt volume dat je zelf nooit snel opbouwt.
- Kosten: first-party vraagt investering in techniek en tijd, third-party kost doorlopend licentiegeld.
- Privacy: first-party geeft je controle over toestemming, third-party brengt vaak onduidelijke consent-ketens mee.
Typische bronnen: je CRM, productgebruik, supportgesprekken en kassadata voor first-party; partnerlijsten voor second-party; en aangekochte intentdata of demografische datasets voor third-party.
Waarom first-party data nu zwaarder weegt dan ooit.
De cookieless toekomst is geen dreiging meer, het is de realiteit waarin je nu al werkt. Browsers blokkeren third-party cookies steeds strenger, en privacywetgeving zoals de AVG maakt het aggregeren van externe data juridisch en operationeel lastiger. Dat verschuift het speelveld structureel richting eigen data, stelt Amperity.
Pro-tip: Wacht niet tot cookies volledig verdwenen zijn. Bouw je first-party infrastructuur nu op, terwijl je nog kunt testen tegen bestaande third-party benchmarks.
Er is ook een technische reden waarom first-party data aan belang wint. AI-modellen en personalisatie-engines hebben schone, contextrijke data nodig om goed te functioneren. Third-party datasets zijn vaak generiek en gemiddeld, first-party signalen zijn specifiek voor jouw klant, jouw product en jouw markt. Amperity wijst er terecht op dat first-party data daardoor beter geschikt is als trainingsmateriaal voor AI-toepassingen dan aangekochte datasets.
Dan is er het economische argument, en dat is misschien wel het overtuigendste. Third-party data huur je: je betaalt, gebruikt het, en bij de volgende licentieronde betaal je opnieuw, zonder dat de data ooit echt van jou wordt. First-party data koop je in feite één keer, met de bouw van je infrastructuur, en daarna wordt het een asset dat blijft groeien. Nederlandse mediabedrijven ondervinden dit uit eerste hand: nu third-party tracking wegvalt, bouwen partijen zoals STER actief eigen datasystemen, een beweging die Emerce goed documenteert.
Wie nu investeert in eigen data, bouwt aan iets dat blijft renderen. Wie blijft huren, betaalt voor altijd voor een fundament dat nooit echt van hem wordt.
Wanneer third-party data toch de moeite waard is
Third-party data verdient geen plek op de schroothoop, mits je het gebruikt waar het goed in is. Marktverkenning is zo’n geval: wil je weten hoe groot een nieuwe doelgroep is voordat je daar zelf data over opbouwt, dan geeft aangekochte data een snelle eerste inschatting. Schaal is een ander sterk punt: third-party bereikt in één keer duizenden accounts die je zelf nooit op tijd in kaart brengt.
Ook als timingsignaal is het waardevol. Intentdata die laat zien dat een bedrijf actief zoekt naar een oplossing als de jouwe, kan het verschil maken tussen een koude en een warme benadering.
Maar er kleven reële risico’s aan:
- Gegevens zijn vaak verouderd tegen de tijd dat je ze gebruikt.
- De toestemmingsketen is zelden transparant, wat privacyrisico verhoogt.
- Concurrenten kopen precies dezelfde datasets, waardoor je nooit een blijvend voordeel opbouwt.
Twilio waarschuwt terecht dat third-party data vaak gebaseerd is op gemiddelden en daarom nooit de primaire kwalificatiebron mag zijn. Beperk daarom altijd de geldigheidsduur van aangekochte data, valideer steekproefsgewijs tegen je eigen resultaten en kies leveranciers die hun herkomstketen kunnen aantonen.
Zo bouw je een first-party datastrategie die werkt
Een goede first-party strategie begint niet bij techniek, maar bij overzicht. Volg deze stappen:
- Inventariseer je bronnen. Zet op een rij waar je al data verzamelt: CRM, website-events, productgebruik, supportgesprekken, kassasystemen en e-mailinteracties. De meeste bedrijven hebben meer bronnen dan ze denken, alleen praten die bronnen niet met elkaar.
- Regel toestemming zichtbaar en simpel. Bouw een preferentiecentrum waar klanten aangeven wat ze willen ontvangen en waarom. Koppel triggers aan echte gebeurtenissen, zoals een download of een demo-aanvraag, zodat toestemming en actie logisch samenvallen.
- Leg een technische basis. Een tagmanager registreert gedrag consistent, een CRM of CDP (Customer Data Platform) bundelt het geheel. Zorg voor eenduidige naamgeving van events: “demo_aangevraagd” moet overal dezelfde betekenis hebben. Voor privacybewuste analysekeuzes is de vergelijking tussen Matomo en GA4 een goed startpunt, zeker als cookieless meting een vereiste wordt.
- Activeer de data. Gebruik segmentatie om doelgroepen te verfijnen, personaliseer boodschappen op basis van gedrag, en voer lead scoring uit op basis van echte interacties in plaats van aannames. Deze signalen vormen ook de schoonste trainingsdata voor AI-toepassingen binnen je marketing.
- Borg governance. Bepaal hoe lang je data bewaart, wie er toegang toe heeft en wanneer je de aanpak evalueert. Een kwartaalcyclus werkt voor de meeste bedrijven goed: genoeg tijd om patronen te zien, kort genoeg om snel te bijstellen.
Pro-tip: Begin met één bron die je perfect op orde brengt, bijvoorbeeld je CRM, voordat je vijf systemen tegelijk probeert te koppelen. Een schone bron levert meer op dan vijf rommelige.
Personalisatie op basis van deze aanpak levert meetbare resultaten op, zoals blijkt uit voorbeelden van gepersonaliseerde campagnes die inspelen op precies dit soort first-party inzicht.
First-party signalen als motor voor betere lead scoring
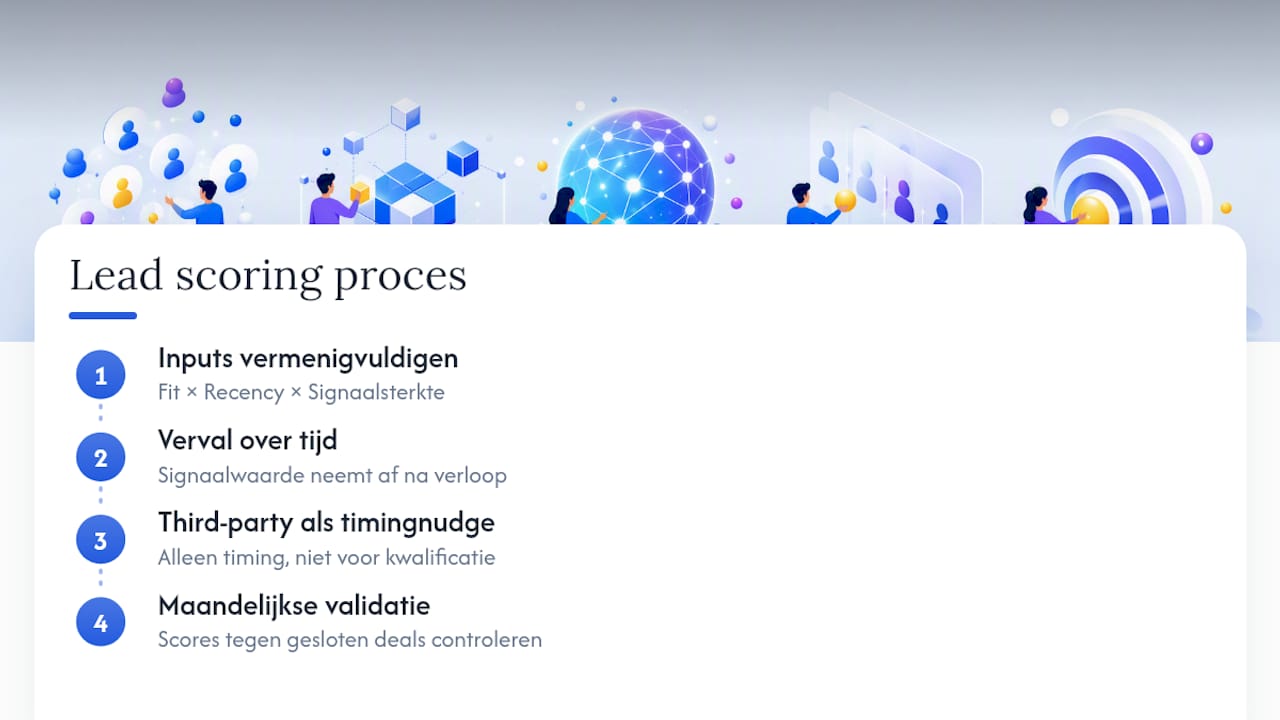
Niet elk signaal is evenveel waard, en dat onderscheid maakt of je salesteam tijd verspilt of juist precies de juiste accounts belt. Gedragingen die een koopintentie direct tonen, wegen het zwaarst: een demo-aanvraag, een directe reactie op een e-mail, of herhaalde bezoeken aan de pricing-pagina. Deze signalen komen rechtstreeks van de persoon zelf, zonder ruis van externe schattingen.
Third-party intentdata speelt een andere rol. Het werkt het best als aanvullende timingsnudge, niet als kwalificatiegrond op zichzelf. Zoals Lead Seeker het stelt: eerste-partij gedrag bepaalt of een account prioriteit krijgt, third-party intent bepaalt alleen het moment.
Een praktische weging combineert drie factoren: fit (past het profiel), recency (hoe recent was het signaal) en signaalsterkte (hoe zwaar telt de actie). Vermenigvuldig deze factoren in plaats van ze simpelweg op te tellen, en bouw een verval in naarmate signalen ouder worden. Valideer deze scoring maandelijks tegen gesloten deals om te zien of je model nog klopt, anders sluipt drift erin zonder dat iemand het merkt. Voor bedrijven met genoeg historische deals (doorgaans meer dan vijfhonderd) wordt predictive scoring met AI haalbaar, zoals Kumo.ai beschrijft; heb je die schaal nog niet, begin dan met een regelgebaseerd model en bouw dat gaandeweg uit.
Hoe Re:Positive signaalgedreven leadgeneratie inzet
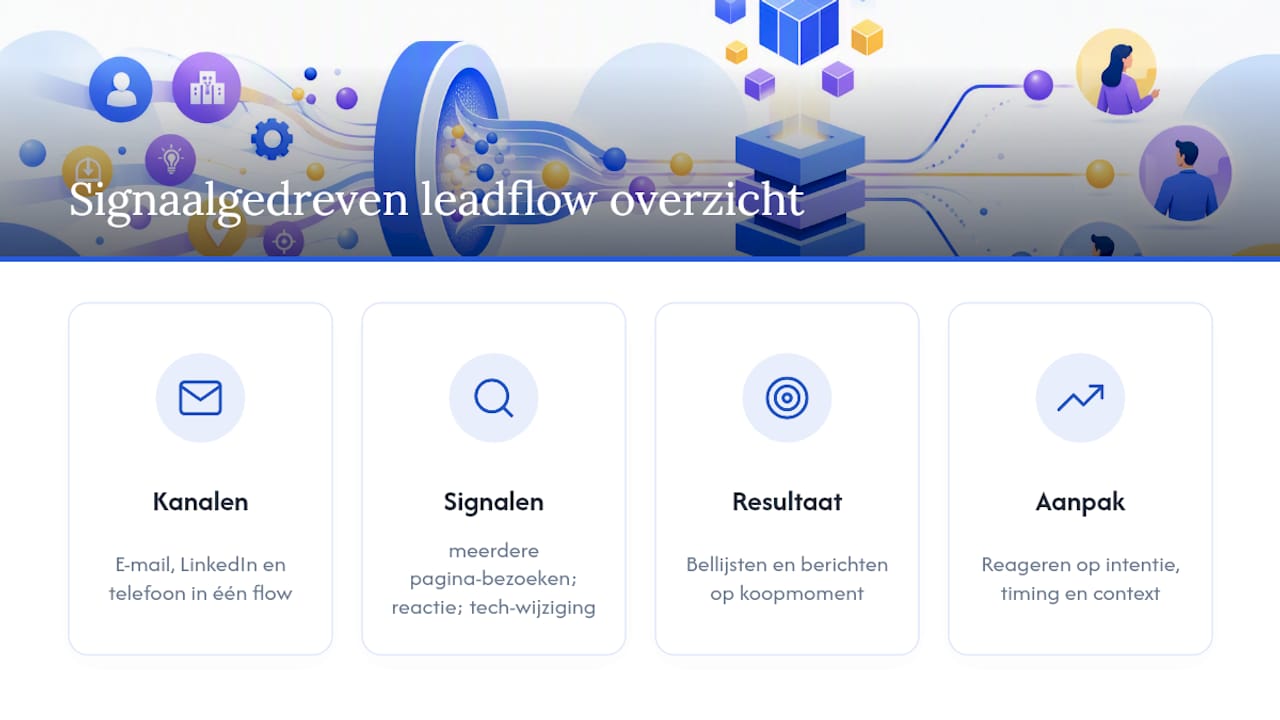
Bij Re:Positive draait alles om het combineren van e-mail, LinkedIn en telefonische opvolging in één doordachte flow, afgestemd op signalen die er echt toe doen. Geen massamail naar een gekochte lijst, maar campagnes die reageren op koopintentie, timing en context.
De signalen die daarbij het zwaarst wegen, zijn precies de first-party signalen uit dit artikel: iemand die een pagina meerdere keren bezoekt, reageert op een bericht, of een technologische verandering doormaakt die publiek zichtbaar is. Die combinatie van publieke bedrijfsinformatie, websiteactiviteit en nieuwsgebeurtenissen vertaalt zich naar bellijsten en berichten die aansluiten bij het moment waarop een bedrijf er klaar voor is.
Dat signaalgedreven werken sluit direct aan op hoe data-driven leadgeneratie in de praktijk meer afspraken oplevert: niet door harder te roepen, maar door slimmer te luisteren naar wat een bedrijf al laat zien.
Redactionele reflectie: waar moet je nu op inzetten?
De meeste marketeers wachten te lang met investeren in eigendom van hun data, omdat het minder spannend voelt dan een nieuwe advertentiecampagne. Dat is een misrekening. Data-eigendom is geen it-project, het is een groeistrategie die zich terugbetaalt zodra cookies verder wegvallen.
Een realistische roadmap kent drie fasen. Begin met quick wins: zet je preferentiecentrum live en leg CRM-events vast die je nu al mist. Bouw daarna de technische basis: een consistente CDP-architectuur en schone naamgeving van events. Pas in de derde fase wordt AI-readiness haalbaar, simpelweg omdat je dan pas genoeg schone data hebt om een model iets te leren.
Evalueer per kwartaal welke signalen daadwerkelijk voorspellen wie converteert, en stel je scoring bij zodra de praktijk afwijkt van het model. Dat is minder werk dan het klinkt, en veel waardevoller dan nog een dataset inkopen.
— Donny
Signaalgedreven leadgeneratie uitbesteden aan Re:Positive
Zelf een first-party datastrategie bouwen kost tijd, en niet elk bedrijf heeft daar een team voor vrij. Re:Positive is het alternatief voor een intern opgetuigd datateam: wij vertalen jouw first-party signalen direct naar afspraken, zonder dat je zelf een CDP moet inrichten of een salesteam moet trainen in signaalherkenning.
Er worden gepersonaliseerde cold outreach-campagnes opgebouwd die e-mail, LinkedIn en telefonische opvolging combineren, aangestuurd door koopintentiesignalen zoals websiteactiviteit, technologische veranderingen en nieuws. Klanten ontvangen doorgaans maandelijkse afspraken, koppeling met een CRM en overzichtelijke rapportage, allemaal op maat gebouwd, zonder standaardsjablonen.
Wil je weten hoe een signaalgedreven outreach-strategie er voor jouw bedrijf uitziet? Plan een gesprek en ontdek binnen een paar weken of dit past bij jouw groeiambitie.
Bronnen
- Cdp
- First-party vs third-party data: what marketers need to know in 2026 | Amperity
- First vs. third party data (Twilio blog)
